Если PDF попал в поиск вместо страницы, это ещё не значит, что поисковик ошибся. Google умеет индексировать текстовые PDF, а Яндекс индексирует подходящие документы этого формата. Когда файл повторяет HTML-материал, поисковая система сопоставляет дубли и выбирает адрес, который считает основным. Задача владельца сайта — определить желаемую версию и передать согласованные сигналы.
Сначала определите правильный результат
Не каждый PDF нужно заменять HTML-страницей в выдаче. Инструкция для печати, форма или документ для скачивания могут быть самостоятельным результатом. Но если HTML-страница содержит основное объяснение, навигацию и актуальную версию материала, а PDF лишь её дублирует, логично сделать предпочтительной страницу.
Запишите решение в явном виде:
- предпочтительный URL;
- URL дублирующего PDF;
- другие адреса того же файла с параметрами или в архивных каталогах;
- внутренние страницы, которые на них ссылаются.
Без такой карты легко получить конфликт: canonical указывает на HTML, меню ведёт на PDF, а карта сайта содержит оба адреса.
Проверьте, действительно ли это дубли
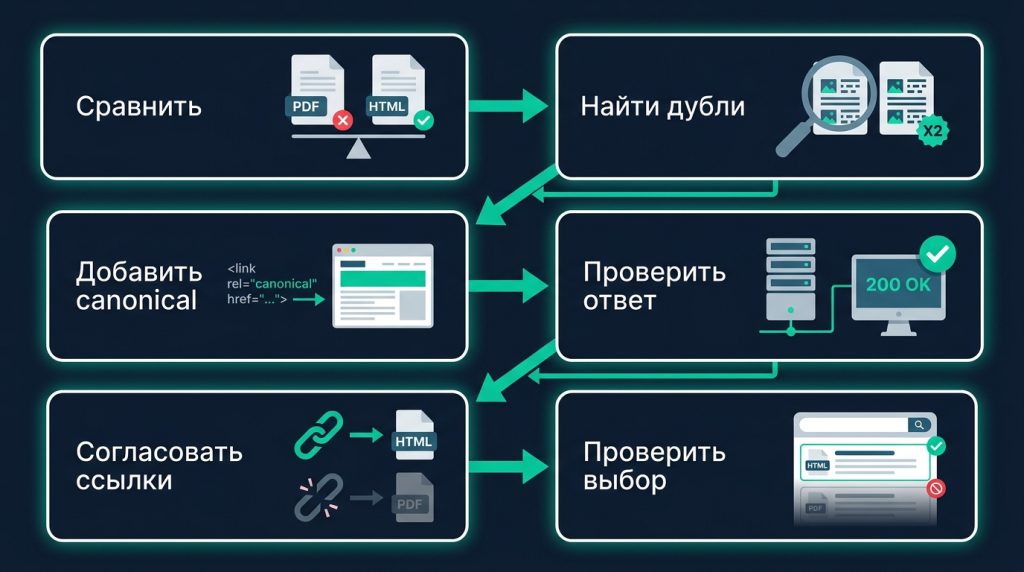
Canonical предназначен для одинаковых или очень похожих документов. Общей темы недостаточно. Сравните заголовок, основной текст, таблицы и назначение материалов.
Если HTML-страница — короткая аннотация, а PDF содержит полное исследование, это разные ресурсы. Указывать страницу канонической для такого файла неправильно. Практичнее оставить PDF отдельным документом, а на странице ясно описать его содержание и дать прямую ссылку.
Если же HTML и PDF воспроизводят один материал, можно собрать сигналы на выбранном адресе. Google рассматривает canonical как сигнал, а не как безусловную команду, поэтому техническая согласованность важна.
Передайте canonical для PDF через HTTP
В PDF нельзя поместить HTML-элемент <link rel="canonical"> в раздел <head>. Для Google канонический адрес такого ресурса передают в HTTP-заголовке Link:
Link: <https://example.ru/article/>; rel="canonical"
Значение должно содержать абсолютный URL. Если предпочтительна HTML-страница, ответ самого PDF указывает на её адрес. Если предпочтителен один из нескольких PDF-адресов, остальные варианты указывают на основной файл.
Яндекс тоже поддерживает HTTP-заголовок Link для указания канонического адреса документа. После настройки запросите заголовки фактического URL:
curl -I -L https://example.ru/files/article.pdf
Проверьте конечный ответ после перенаправлений. Убедитесь, что Link ведёт на существующую предпочтительную версию, использует нужный протокол и домен и не образует противоречивую цепочку.
Не подменяйте canonical директивой noindex
X-Robots-Tag: noindex запрещает индексировать PDF. Canonical обозначает предпочтительную версию среди дублей. Это разные задачи.
Если файл должен оставаться доступным пользователям, но не должен быть отдельным результатом поиска, noindex технически применим к PDF через HTTP-ответ. Однако такой выбор не равнозначен консолидации дублей. Когда задача именно в том, чтобы выбрать HTML-версию среди одинаковых материалов, canonical точнее описывает отношения между ними.
Кроме того, робот должен получить ответ, чтобы увидеть X-Robots-Tag. Блокировка URL в robots.txt может помешать прочитать HTTP-директиву. Поэтому сочетание запрета сканирования и noindex нельзя считать надёжным способом управления известным файлом.
Согласуйте внутренние сигналы
После установки canonical пройдите по сайту и исправьте ссылки на дублирующий PDF там, где пользователь должен попасть на HTML-страницу. Если скачивание всё же нужно, оставьте отдельную, ясно подписанную ссылку на файл, чтобы не создавалось впечатления, что оба URL — основные страницы.
Проверьте следующее:
- Основная навигация и контекстные ссылки ведут на предпочтительный URL.
- В карте сайта указан адрес, который сайт считает основным.
- HTTP canonical на PDF не конфликтует с выбранной версией.
- Нет альтернативных копий файла в старых каталогах.
- Перенаправления не возвращают пользователя к дублю.
В документации Google советуют использовать методы канонизации согласованно. Внутренние ссылки и карта сайта тоже служат сигналами, а заголовок Link позволяет выразить связь прямо в ответе PDF.
Убедитесь, что HTML-страница доступна для обработки
Страница не будет выбрана, если робот не может её получить или она сама закрыта от индексирования. Проверьте серверный ответ предпочтительного URL и поисковые директивы. Заодно убедитесь, что страница действительно содержит версию материала, сопоставимую с PDF.
С файлом тоже должно быть всё в порядке. Пароль и шифрование, как правило, мешают Google извлечь содержимое PDF. Для Яндекса важны ограничение размера PDF до 10 МБ и текстовый слой; у документов только из изображений распознаются первые три страницы. Эти свойства помогают понять, как поисковая система видит пару материалов, но сами по себе не заставляют её выбрать HTML.
Если нужно понять, как по-разному обе системы выбирают версию, пригодится сравнение индексации в Google и Яндексе: оно не заменяет canonical, доступность и исправление внутренних ссылок. Расширенная диагностика PDF собрана в блоге SpeedyIndex.
Практический порядок действий
- Выберите основную версию, исходя из реального сходства материалов.
- Соберите все URL PDF и HTML-дублей.
- В ответе PDF установите
Linkс абсолютным каноническим адресом. - Проверьте заголовок после всех перенаправлений.
- Направьте внутренние ссылки и карту сайта на предпочтительную версию.
- Устраните конфликтующий
noindexна основной странице. - Оставьте PDF самостоятельным, если его содержание существенно отличается.
- Не считайте отсутствие в выдаче по одному запросу точным доказательством состояния индекса.
После изменений поисковая система должна заново получить ресурсы и оценить сигналы. Официальная документация не позволяет обещать ни конкретных результатов, ни обязательного выбора указанной версии.
FAQ
Нужно ли удалять PDF с сервера?
Нет, если файл нужен пользователям. Для близких дублей можно обозначить предпочтительный URL через HTTP canonical и согласовать ссылки. Удаление — отдельное решение о доступности контента.
Можно ли поставить canonical внутри PDF?
Не как HTML-тег. Для PDF canonical передают в HTTP-заголовке Link, причём Google советует использовать абсолютный URL.
Почему Google может не выбрать указанный canonical?
Google воспринимает canonical как сигнал и может выбрать другую версию. Проверьте, что материалы действительно дублируются и что заголовок, внутренние ссылки, карта сайта и перенаправления не противоречат друг другу.